Radar IA: modelos especialistas, decisiones rápidas y agentes que se pueden medir
Por José Ramón Vergara · Negocio y construcción con IA
Shopify, OpenAI, Mistral, Cohere y Decagon: cinco novedades del 19 al 25 de octubre para construir con más criterio.
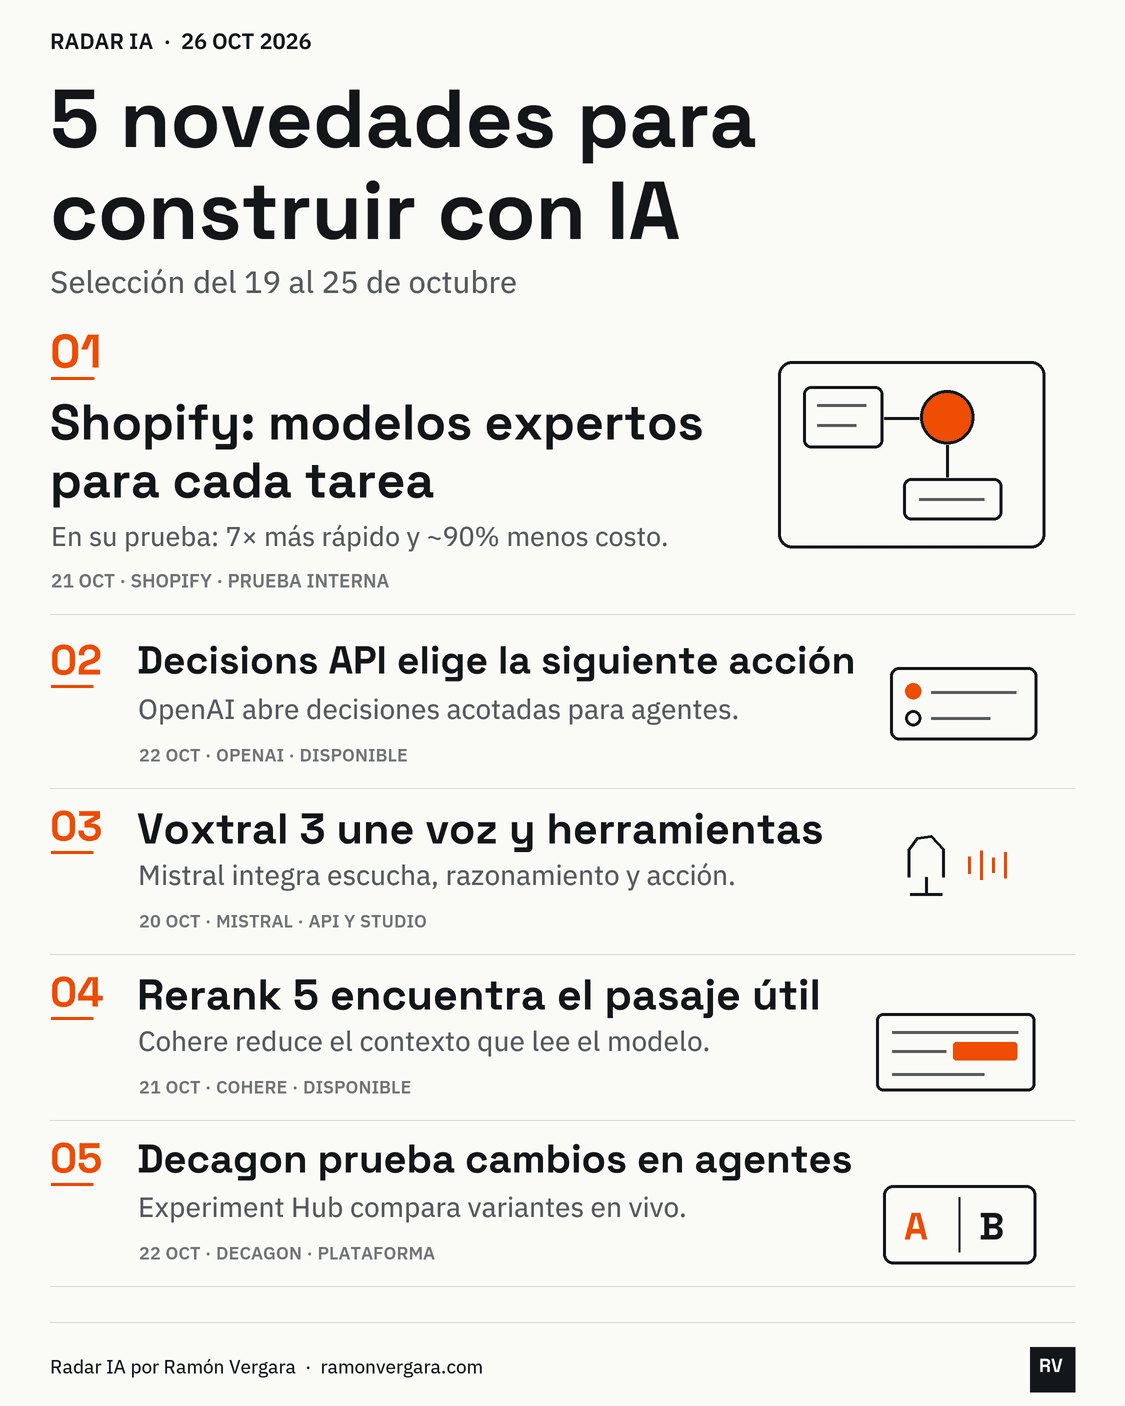
26 de octubre de 2026 · Semana del 19 al 25 de octubre
Esta edición pregunta cuánto trabajo asignar a cada modelo y cómo medir el resultado. Shopify publicó una implementación; cuatro proveedores presentaron herramientas para decidir, conversar, encontrar contexto y medir agentes. Son cinco novedades verificadas en sus originales. No he probado los productos; las cifras pertenecen a cada evaluación.
1. Shopify convierte un modelo abierto en especialista para Sidekick
Shopify explicó el 21 de octubre cómo reparte el trabajo dentro de Sidekick, su asistente para comerciantes. Un modelo de frontera conversa con la persona y decide qué herramienta llamar. Para una tarea acotada, consultar datos de la tienda mediante GraphQL, usa un subagente basado en Nemotron 3.5 Lightning que Shopify ajustó y sirve en su propia infraestructura.
El resultado reportado merece atención por su contexto. En el evaluador interno de Shopify, el modelo ajustado obtuvo 74,5 puntos frente a 73 del modelo de frontera. En una reproducción de tráfico de producción, respondió en 0,87 segundos de mediana frente a 6,50, y Shopify estima cerca de 90% menos costo de servicio. Son cifras de esa tarea y esa comparación, no una promesa para todo agente.
Me interesa el método: definir una rúbrica, contrastarla con etiquetas humanas, mejorar el agente de referencia y entrenar el especialista con ejemplos corregidos. El ahorro vino de conocer una tarea repetida. Implementación y medición originales de Shopify.
2. Decisions API pone respuestas acotadas en el flujo
OpenAI hizo generalmente disponible Decisions API el 22 de octubre. En vez de pedir una respuesta extensa, el desarrollador define una pregunta, las respuestas permitidas y el contexto. La API devuelve una probabilidad, una elección o una puntuación. Sirve para clasificar una entrada, decidir si un agente continúa o derivar una excepción a una persona.
OpenAI afirma que estas decisiones pueden ser hasta diez veces más rápidas que usar GPT-6 Luna mediante Responses API. La comparación depende de la carga. Ya admite imágenes, JSON, caché y hasta 400 preguntas por solicitud; también se integra con GPT-Live.
Está disponible con GPT-6 Luna en su endpoint propio. Antes de colocarlo en un paso crítico, probaría ejemplos reales, mediría errores por tipo y definiría qué nivel de confianza exige revisión humana. Una elección rápida también puede ser una elección equivocada. Anuncio y guía de OpenAI.
3. Voxtral 3 reúne las piezas de un agente de voz
Mistral presentó Voxtral 3 el 20 de octubre: modelos de transcripción y síntesis de voz más un SDK para conectar escucha, razonamiento, llamadas a herramientas y respuesta hablada. El SDK funciona como una tubería de streaming; la empresa muestra una llamada donde el agente interpreta una referencia médica y propone reservar una cita. Eso es una demostración, no evidencia de operación clínica.
La familia incluye transcripción con identificación de hablantes y vocabulario contextual. Mistral reporta cobertura de más de 50 idiomas en su modelo de transcripción principal; los modelos de tiempo real y de voz generada tienen coberturas diferentes. Vale la pena comprobar el idioma y el acento concretos antes de diseñar un servicio para LATAM.
Se puede probar mediante la API y Studio. Mistral también ofrece despliegue en infraestructura propia mediante contacto comercial. La pregunta de diseño es cómo manejar interrupciones, autorizaciones y errores cuando el agente puede actuar mientras conversa. Presentación original de Mistral.
4. Rerank 5 recorta el contexto antes de enviarlo al modelo
Cohere lanzó Rerank 5 Pro y Fast el 21 de octubre. Un reranker vuelve a ordenar documentos recuperados para que el modelo lea los más pertinentes. La función nueva, Context Focus, señala los fragmentos relevantes dentro de cada documento. En un sistema que consulta archivos largos repetidamente, menos texto de entrada puede reducir costo y latencia.
Cohere reporta mejores resultados en varios benchmarks de recuperación y muestra pruebas de compresión de contexto. Esas mediciones son del proveedor; conviene repetirlas con consultas y documentos propios. Un recorte agresivo podría quitar precisamente el dato que cambia una respuesta. Pro y Fast están disponibles en la API de Cohere y otras plataformas indicadas en el anuncio; los despliegues privados requieren coordinación comercial. Lanzamiento original de Cohere.
5. Decagon propone experimentar sobre agentes en producción
Decagon presentó Experiment Hub el 22 de octubre para probar cambios concretos en sus agentes de atención. Permite variar una instrucción o un paso del flujo, repartir tráfico y observar métricas como resolución, calidad, latencia y costo por conversación. La herramienta mantiene cada conversación en su variante y puede detener una prueba si una opción empeora claramente una métrica.
El ejemplo de un saludo distinto parece pequeño, pero apunta a un problema frecuente: cambiar varias cosas a la vez y luego atribuirse una mejora que no se puede explicar. Decagon incluye un testimonio de Chime sobre pruebas en un agente de soporte; no presenta ahí una mejora universal cuantificada. El acceso corresponde a equipos que usan su plataforma. Anuncio y demostración de Decagon.
Esta semana elegiría una tarea repetida, definiría qué cuenta como buen resultado y compararía una alternativa a la vez. El nombre del modelo importa menos que la evidencia que deja en ese trabajo.
Sigamos por correo.
Novedades de IA con fuentes, contexto y límites claros.