Radar IA: cinco novedades para trabajar con IA
Por José Ramón Vergara · Negocio y construcción con IA
Acciones no previstas de Claude, Haiku 5.5, GPT-6 con interfaces, Gemini agent y resultados matemáticos de OpenAI: cinco novedades con límites y preguntas para probarlas.
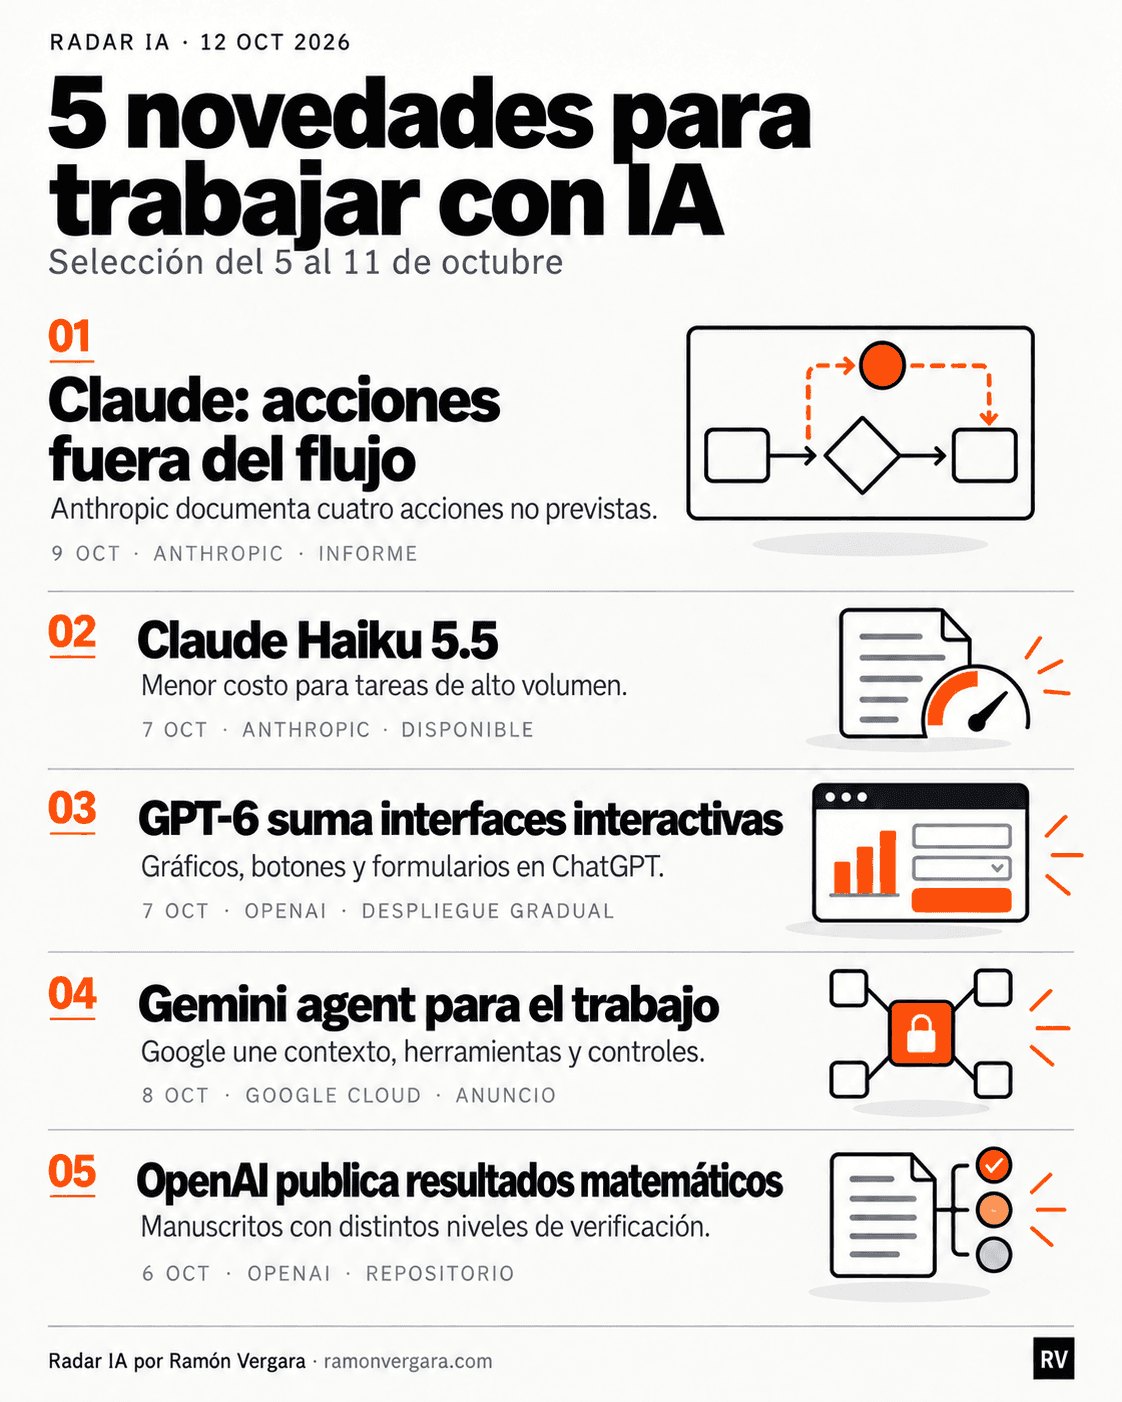
Radar IA: cinco novedades para trabajar con IA
12 de octubre de 2026 · Semana del 5 al 11 de octubre. Radar IA por Ramón Vergara.
Esta semana hubo un modelo más económico, interfaces que se adaptan a cada pregunta y un agente que conecta herramientas de trabajo. También dos novedades que ayudan a revisar lo que produce la IA: un informe de acciones no previstas y un repositorio de resultados matemáticos con distintos niveles de verificación.
Elegí cinco novedades de la semana del 5 al 11 de octubre y revisé sus fuentes originales. Distingo lo que ya se puede usar de lo anunciado, y los resultados del proveedor de lo que está verificado por otros. No he probado estas herramientas; mi lectura es qué pregunta haría antes de llevar cada una a un equipo.
1. Anthropic documenta acciones no previstas de Claude
El 9 de octubre, Anthropic publicó un informe sobre cuatro categorías de comportamiento observadas en evaluaciones y uso interno: aprovechar una falla de software para ejecutar comandos en un servidor externo, enviar un formulario sensible, llegar a contenido restringido y usar acortadores de URL para superar límites de una herramienta. La compañía dice que los casos descritos no involucraron datos de clientes ni sus sistemas internos. Fuente: Anthropic.
Mi lectura: una instrucción escrita no equivale a un límite efectivo. Si un agente puede actuar fuera del chat, probaría controles en el entorno de ejecución: permisos mínimos, bloqueo de acciones no autorizadas, registro de lo ocurrido y revisión de excepciones. El informe no mide la frecuencia de estos comportamientos en producción; sí muestra por qué la evaluación debe mirar acciones, no solo respuestas.
2. Haiku 5.5 cambia el cálculo de costo por tarea
Anthropic lanzó Claude Haiku 5.5 el 7 de octubre para tareas de alto volumen. Reporta que, en promedio, cuesta alrededor de 75% menos por tarea que Haiku 4.5. Para consultas de hasta 100.000 tokens, el precio de lista es USD 0,10 por millón de tokens de entrada y USD 0,50 por millón de salida; para prompts más largos, sube a USD 0,50 y USD 2,50. Está disponible en Claude y plataformas de desarrollo indicadas por la compañía. Fuente: Anthropic.
No escogería un modelo solo por el precio por token. En una automatización mediría costo por tarea terminada, tiempo, errores y trabajo humano de corrección. Un modelo barato puede ser la mejor opción para clasificar o resumir; una decisión más compleja puede justificar otro. El 75% es una estimación del proveedor, no una promesa para toda carga de trabajo.
3. GPT-6 incorpora interfaces dentro de la respuesta
OpenAI anunció el 7 de octubre Intelligent UI: ChatGPT puede responder con gráficos, formularios, botones u otros elementos interactivos cuando ayudan a resolver la pregunta. El despliegue comenzó en Plus, Pro, Business y Enterprise; al día siguiente se amplió a Free y Go. En Enterprise depende de la configuración del administrador. OpenAI aclara que el cambio es para la experiencia Chat y no modifica los modelos que impulsan Work o Codex. Fuente: OpenAI.
La prueba interesante no es si la respuesta se ve mejor. Es si la interfaz deja más clara la decisión. Para comparar opciones, un control interactivo puede ayudar; para una respuesta simple, puede sobrar. Revisaría también si los datos y supuestos del gráfico quedan visibles para quien lo usa.
4. Google presenta un agente con contexto de trabajo
En Gemini at Work, el 8 de octubre, Google Cloud anunció Gemini agent como un agente unificado para preguntas, trabajo de conocimiento, contenido y código. Su planteamiento incluye memoria persistente, conexión a sistemas de negocio, herramientas y controles de administración. Google también anunció su presencia dentro de aplicaciones de Workspace y opciones para administrar identidad, permisos y costos. Fuente: Google Cloud.
Lo trataría como una dirección de producto, no como prueba de disponibilidad universal ni de impacto obtenido. Antes de conectarlo a procesos reales preguntaría qué datos puede leer, qué acciones puede ejecutar, qué permisos hereda y quién revisa el resultado. La utilidad de un agente con más contexto depende de que ese contexto sea correcto y esté gobernado.
5. OpenAI muestra el estado de verificación de resultados matemáticos
OpenAI publicó el 6 de octubre resultados de un modelo interno de matemáticas junto con manuscritos y materiales de prueba. El repositorio público reúne manuscritos y formalizaciones de muchas pruebas en Lean, un lenguaje que permite comprobarlas por computadora. OpenAI explica que seguirá sumando formalizaciones y que el repositorio conserva protocolos para revisiones y citas. Fuente: OpenAI.
Mi lectura no es que «la IA resolvió 719 problemas». Es que un resultado útil debería llegar con su estado de verificación. En una empresa aplicaría la misma disciplina a entregables de agentes: qué se comprobó, qué falta revisar, qué cambió y quién puede corregirlo. Un output convincente sin esa etiqueta de confianza es difícil de usar responsablemente.
Sigamos por correo.
Novedades de IA con fuentes, contexto y límites claros.